Siber Güvenlik
Wazuh Health Check: Servis, Indexer ve Kopan Agent
Wazuh health check: wazuh-control status, indexer kümesinin rengi, Filebeat, disk, kopan agent alarmı ve e-posta eşiği, günlük ve haftalık liste, lab ölçümüyle.

- Wazuh Sağlık Kontrolü Nasıl Olmalı?
- Wazuh Servisleri: wazuh-control status
- Indexer Kümesi: Renk, Shard ve Disk
- Filebeat: Alarmlar Indexer’a Ulaşıyor mu?
- Wazuh Agent Disconnected: Kopma Ne Zaman Görünür?
- Kopma Alarmını E-posta Eşiğine Taşımak: Kural 100160
- Server Dururken Gelen Olaylar Kaybolur mu?
- Server Log’u ve Kuyruklar: ossec.log ve analysisd.state
- Dashboard’un Sağlık Ekranları
- Günlük ve Haftalık Wazuh Sağlık Listesi
- Wazuh Sağlık Kontrolünde Sık Yapılan Hatalar
- Sonuç: Wazuh Kendini İzlemez, Onu Bir Liste İzler
- Wazuh Sağlık Kontrolü Hakkında Sık Sorulan Sorular
Wazuh health check (sağlık kontrolü), Wazuh’un kendi parçalarının çalıştığını düzenli olarak doğrulamaktır: server’ın servisleri, indexer kümesi, alarmları indexer’a taşıyan Filebeat, disk ve agent’ların bağlantısı. Wazuh başka makinelerin olaylarını izler, ama kendisi bozulduğunda bunu çoğu zaman kimseye haber vermez. Bozuk bir Wazuh’un ekranı da sakin bir günün ekranı gibi görünür: alarm yok.
Bu yazı Wazuh rehberimizin on üçüncü adımıdır. Lab’da önce Wazuh’un parçalarını tek tek ölçtüm: servis listesinde neyin normalde kapalı durduğunu, indexer kümesinin rengini ve diski, Filebeat’in indexer’a ulaşıp ulaşmadığını, server log’unda biriken uyarıları ve atılan olay sayısını. Sonra bir agent’ı iki yoldan kopardım. Önce servisini düzgün durdurdum, sonra makineyi haber vermeden dondurdum. İki kopmanın ne zaman göründüğünü ve hangi alarmı ürettiğini ölçtüm. Son olarak server’ı üç dakika durdurdum ve o sırada agent’ta oluşan olayların kaybolup kaybolmadığına baktım.
Rehberde agent’ı abonedeki akıllı sayaca, server’ı da arıza merkezine benzettik. Akıllı sayaç merkeze yalnız arıza olunca yazmaz, her birkaç saniyede bir “buradayım” der. Sinyal belli bir süre gelmezse merkez o sayacı kopuk sayar. Elektrikçi sayacı sökerken merkeze haber verirse kayıt hemen düşer. Sayaç sessizce susarsa merkez bunu ancak süre dolunca fark eder.
Merkezin kendi binası da bakım ister. Kayıt dolabı dolarsa yeni ihbarı yazacak yer kalmaz. Telsiz bozulursa sokaklardan haber gelmez. İkisinde de merkezin ekranı sakin görünür, çünkü ihbar gelmiyordur. Sessiz sokak her zaman huzurlu sokak değildir. Bu yüzden nöbeti devralan görevli ilk iş merkezin kendisine bakar.
Wazuh’ta “buradayım” sinyali agent’ın keepalive mesajıdır, kopuk sayaç Disconnected durumudur. Kayıt dolabı indexer’ın diskidir, telsiz de alarmları indexer’a taşıyan Filebeat. Nöbet başındaki bakış ise bu yazının sonundaki günlük listedir.

Bu makale Siber Güvenlik ana hizmetimizin güvenlik izleme koluna, özellikle Wazuh’un kendisinin izlenmesine odaklanır. İzlemenin kimin elinde nasıl yürüdüğünü SIEM hizmeti sayfamızda anlattık.
Wazuh Sağlık Kontrolü Nasıl Olmalı?
Önce kısa cevap: iki şeye her gün, beş şeye her hafta bakılır. Her gün kopan agent listesine ve indexer kümesinin rengine bakılır. Her hafta servisler, Filebeat’in bağlantısı, disk, server log’undaki hatalar ve atılan olay sayısı okunur. Kopan agent fabrika ayarında e-posta getirmez, bu yüzden kopma alarmını e-posta eşiğine taşıyan bir özel kural yazılır. Disk, indexer’ın kendi eşiklerinden önce uyarmalıdır.
Bu düzen üç kaynağa dayanıyor:
- Wazuh belgesi: agent bağlantısı sayfası agent durumlarını ve kontrol araçlarını sayar. Global ayarlar sayfası da server’ın agent’ı son keepalive mesajından kaç dakika sonra kopuk sayacağını yazar: fabrika değeri 15 dakika.
- OpenSearch belgesi: küme ayarları disk eşiklerini %85, %90 ve %95 olarak verir. %95’te düğümdeki indeksler salt okunur olur, yani yeni alarm yazılmaz.
- NIST SP 800-53, AU-5: log kaydı sürecinin arızası belirlenen kişiye belirlenen sürede bildirilir. AU-5(1) de storage kapasitesi belirlenen yüzdeye ulaşınca uyarı ister, yani dolmadan önce.
| Ne zaman | Neye bakılır | Nerede |
|---|---|---|
| Her gün | Kopan agent | Dashboard’da Endpoints özeti, agent_control -ln |
| Her gün | Küme rengi | _cluster/health |
| Her hafta | Servisler | wazuh-control status |
| Her hafta | Filebeat | filebeat test output |
| Her hafta | Disk | df -h, _cat/allocation |
| Her hafta | Log ve atılan olay | ossec.log, wazuh-analysisd.state |
| Bir kez | Kopma alarmının e-postası | Özel kural (bu yazıda 100160) |
Wazuh Servisleri: wazuh-control status
Server’ın kendi süreçlerini wazuh-control listeler:
sudo /var/ossec/bin/wazuh-control statuswazuh-clusterd not running...
wazuh-modulesd is running...
wazuh-monitord is running...
wazuh-logcollector is running...
wazuh-remoted is running...
wazuh-syscheckd is running...
wazuh-analysisd is running...
wazuh-maild not running...
wazuh-execd is running...
wazuh-db is running...
wazuh-authd is running...
wazuh-agentlessd not running...
wazuh-integratord not running...
wazuh-csyslogd not running...
wazuh-apid is running...Beş satırın not running olması arıza değildir. Bu süreçler kullanılmayan özelliklere aittir: wazuh-clusterd çok sunuculu kümeye, wazuh-maild e-posta bildirimine, wazuh-integratord dış entegrasyonlara. Lab server’ı tek sunucuydu ve e-posta bildirimi kapalıydı. Belgedeki örnek çıktıda da aynı satırlar not running görünür. Asıl bakılacak olanlar şunlardır:
| Süreç | Durursa ne olur? |
|---|---|
wazuh-remoted | Agent’lar server’a bağlanamaz |
wazuh-analysisd | Olaylar kurallarla eşlenmez, alarm üretilmez |
wazuh-db | Agent listesi ve durum sorguları çalışmaz |
wazuh-modulesd | Zafiyet tespiti ve envanter gibi modüller durur |
wazuh-apid | Dashboard server’a ulaşamaz |
Aynı liste wazuh-control -j status ile JSON olarak alınır. Bir izleme betiği bunu okuyup running olmayan beklenmedik bir süreçte uyarı verebilir. systemctl status wazuh-manager da servisin ne kadar bellek kullandığını gösterir. Lab’da yeniden başlatmadan beş dakika sonra 1 GB’tı.
Indexer Kümesi: Renk, Shard ve Disk
Indexer’ın sağlığı REST API’sine sorulur. Lab’da sorguları, kurulumun ürettiği admin sertifikasıyla çalışan kısa bir betikle yaptım. Böylece komut satırına parola yazılmaz:
#!/bin/bash
# siem01'de: ix.sh <yol>  Indexer GET, admin istemci sertifikasi, parolasiz.
sudo curl -s --cert /etc/wazuh-indexer/certs/admin.pem --key /etc/wazuh-indexer/certs/admin-key.pem --cacert /etc/wazuh-indexer/certs/root-ca.pem "https://127.0.0.1:9200/$1"
Kümenin rengi _cluster/health sorgusundadır:
bash ~/ix.sh "_cluster/health?pretty"{
"cluster_name" : "wazuh-cluster",
"status" : "green",
"timed_out" : false,
"number_of_nodes" : 1,
"number_of_data_nodes" : 1,
"discovered_master" : true,
"discovered_cluster_manager" : true,
"active_primary_shards" : 35,
"active_shards" : 35,
"relocating_shards" : 0,
"initializing_shards" : 0,
"unassigned_shards" : 0,
"delayed_unassigned_shards" : 0,
"number_of_pending_tasks" : 0,
"number_of_in_flight_fetch" : 0,
"task_max_waiting_in_queue_millis" : 0,
"active_shards_percent_as_number" : 100.0
}Üç renk üç farklı durumu söyler:
- Green: bütün shard’lar yerinde.
- Yellow: asıl shard’lar çalışıyor, en az bir replika yerleşemedi. Tek sunuculu kümede bunun en sık nedeni replika isteyen bir indekstir. Kalıcı çözümünü Wazuh kurulumu yazımızda anlattık.
- Red: en az bir asıl shard yok. O indekse yazılan ya da o indeksten okunan alarm kaybolur.
unassigned_shards sıfırdan büyükse hangi shard’ın neden yerleşemediğini _cat/shards gösterir. Disk ise _cat/allocation ile okunur:
bash ~/ix.sh "_cat/allocation?v"shards disk.indices disk.used disk.avail disk.total disk.percent host ip node
35 19.3mb 28.9gb 18.9gb 47.8gb 60 127.0.0.1 127.0.0.1 node-1Bu çıktı önemli bir ayrıntıyı gösterir: indekslerin kendisi 19,3 MB tutuyordu, ama diskin 28,9 GB’ı doluydu. Indexer’ın disk eşiği indekslere değil, bütün diske bakar. Lab’da diski dolduran Wazuh server’ının zafiyet veritabanıydı:
df -h /Filesystem Size Used Avail Use% Mounted on
/dev/nvme0n1p2 48G 27G 19G 59% /du aynı anda /var/ossec/queue/vd klasörünü 13 GB, indexer’ın veri klasörünü 26 MB ölçtü. df ve du çıktılarını okumayı Linux disk yönetimi yazısında anlattık. Yani tek sunuculu bir Wazuh’ta indeks büyüklüğüne bakmak yetmez. Disk %85’e ulaşmadan önce uyarı veren bir kontrol gerekir. NIST AU-5(1)‘in istediği de budur: disk dolmadan önce uyarı.
Filebeat: Alarmlar Indexer’a Ulaşıyor mu?
Server alarmı önce kendi diskine, /var/ossec/logs/alerts/alerts.json dosyasına yazar. Filebeat bu dosyayı okur ve indexer’a gönderir. Filebeat durursa alarm server’da üretilmeye devam eder, ama dashboard’a ulaşmaz. Ekranda yalnız alarmların azaldığı görünür.
Filebeat iki komutla sınanır. Biri yapılandırmayı, öteki indexer’a bağlantıyı sınar:
sudo filebeat test config
sudo filebeat test outputConfig OK
elasticsearch: https://127.0.0.1:9200...
parse url... OK
connection...
parse host... OK
dns lookup... OK
addresses: 127.0.0.1
dial up... OK
TLS...
security: server's certificate chain verification is enabled
handshake... OK
TLS version: TLSv1.2
dial up... OK
talk to server... OK
version: 7.10.2Her satırın sonunda OK olmalı. handshake satırında hata varsa sertifika, dial up satırında hata varsa indexer’ın kendisi ya da firewall bakılacak yerdir.
Wazuh Agent Disconnected: Kopma Ne Zaman Görünür?
Agent server’a düzenli aralıklarla keepalive mesajı gönderir. Lab agent’ında bu aralık 20 saniyeydi (<notify_time>20</notify_time>). Server, son keepalive’dan agents_disconnection_time kadar süre geçince agent’ı kopuk sayar. Fabrika değeri 15 dakikadır. Kopan agent’lar şöyle listelenir:
sudo /var/ossec/bin/agent_control -ln
Wazuh agent_control. List of available agents:
   ID: 002, Name: ankmuh01, IP: any, Disconnected
   ID: 003, Name: dc01, IP: any, Disconnected

List of agentless devices:
-lc bağlı agent’ları, -i ile verilen kimlik de tek agent’ın ayrıntısını gösterir. Ayrıntıdaki Last keep alive satırı son keepalive’ın zamanını Unix zaman damgası olarak verir.
Wazuh agent yazısında kurduğumuz lnx02 agent’ını iki farklı yoldan kopardım. Sonuçlar birbirinden çok farklı çıktı:
| Servis durduruldu | Makine haber vermeden dondu | |
|---|---|---|
| Ne yapıldı? | lnx02’de systemctl stop wazuh-agent | lnx02 sanal makinesi duraklatıldı |
| Disconnected ne zaman? | 2 saniye içinde | Son keepalive’dan 18 dakika sonra |
| Gelen alarm | 506, Wazuh agent stopped. | 504, Wazuh agent disconnected. |
| Gelmeyen alarm | 504 (17 dakika beklendi) | 506 |
| Alarm seviyesi | 3 | 3 |
Servis durdurulunca agent server’a kapandığını bildirdi. Server agent’ı hemen kopuk saydı ve 506 alarmını üretti. 504 gelmedi. Servis yeniden başlatılınca 503 alarmı (Wazuh agent started.) geldi ve agent yaklaşık 20 saniye içinde Active oldu.
Makine haber vermeden donunca server hiçbir şey duymadı. Agent 18 dakika boyunca listede Active göründü. Sonra 504 alarmı düştü ve durum Disconnected oldu. 504’ün alerts.json kaydında olay satırı ossec: Agent disconnected: 'lnx02-any'., kaynağı wazuh-monitord idi.
Ayar 15 dakikaydı, ölçülen süre 18 dakika. Yani kopma alarmı ayarlanan süreden birkaç dakika sonra da gelebilir. Makine çalışmaya devam edince agent iki saniye içinde bağlantısının koptuğunu fark etti ve aynı saniyede yeniden bağlandı. Kendi log’una şunu yazdı:
2026/11/14 00:23:15 wazuh-agentd: WARNING: Server unavailable. Setting lock.
2026/11/14 00:23:15 wazuh-agentd: INFO: Closing connection to server ([192.168.1.47]:1514/tcp).
2026/11/14 00:23:15 wazuh-agentd: INFO: Trying to connect to server ([192.168.1.47]:1514/tcp).
2026/11/14 00:23:15 wazuh-agentd: INFO: (4102): Connected to the server ([192.168.1.47]:1514/tcp).
2026/11/14 00:23:15 wazuh-agentd: INFO: Server responded. Releasing lock.
lnx02’nin saati UTC’dir. 00:23 UTC, server saatiyle 03:23’tür.
Bu iki sonuç bir tuzak gösterir. Kopma alarmı yalnız 504’e bağlanırsa, servisi bilerek durdurulan agent hiç alarm üretmez. Saldırganın agent’ı kapatması da bu yoldan gelir. 504’ün MITRE eşlemesi zaten T1562.001, yani savunma araçlarını devre dışı bırakmaktır. Bu yüzden günlük listede yalnız alarma değil, Disconnected listesinin kendisine de bakılır.
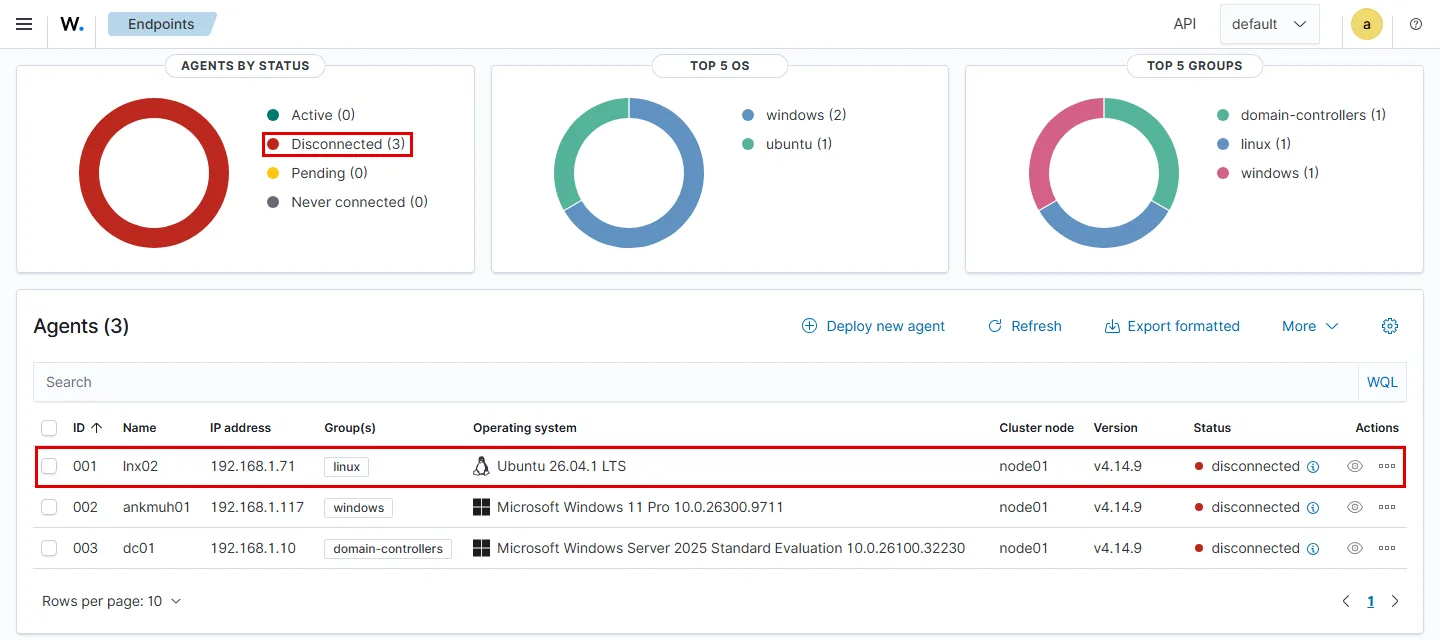
Dashboard’da aynı liste Endpoints özetindedir: sol menüde Agents management > Summary. Belgeye göre dashboard ayrıca her 15 dakikada bir bütün agent’ların durumunu wazuh-monitoring indeksine yazar. Geçmişte bir agent’ın ne zaman koptuğu bu indeksten bulunur.
Kopma Alarmını E-posta Eşiğine Taşımak: Kural 100160
504 ve 506 seviye 3’tür. Fabrika ayarında e-posta eşiği (email_alert_level) ise 12’dir. Yani kopan agent, e-posta bildirimi açık olsa bile kimseye e-posta göndermez. Bunu değiştiren, 504’ü seviye 12’ye taşıyan bir özel kuraldır. Özel kuralın yapısını rehberin kural seviyeleri adımında anlattık. Kural server’daki /var/ossec/etc/rules/local_rules.xml dosyasına eklenir:
<group name="local,wazuh_saglik,">
  <rule id="100160" level="12">
    <if_sid>504</if_sid>
    <description>Wazuh agent baglantisi koptu</description>
  </rule>
</group>
if_sid kuralı 504’ün üstüne kurar. 504 düşen her olayda bu kural da çalışır ve seviyesi 12 olur. Kimlik 100000 ve üstündeki boş bir numara olmalıdır. Lab’ın dosyasında 100001’den 100150’ye kadar başka özel kurallar vardı, 100160 boştu. Aynı yapı 506 için de kurulabilir, ama bakım için kapatılan her agent o zaman e-posta getirir. Hangisinin kuruma uyduğu bakım düzenine bağlıdır.
Değişiklik server yeniden başlatılmadan önce sınanır. wazuh-logtest bir olay satırını alır ve hangi kuralın düşeceğini gösterir. Satır olarak 504’ün alerts.json’daki olay satırı verildi:
printf "ossec: Agent disconnected: 'lnx02-any'.\n" | sudo /var/ossec/bin/wazuh-logtest 2>&1Starting wazuh-logtest v4.14.9
Type one log per line
**Phase 1: Completed pre-decoding.
full event: 'ossec: Agent disconnected: 'lnx02-any'.'
**Phase 2: Completed decoding.
name: 'ossec'
**Phase 3: Completed filtering (rules).
id: '100160'
level: '12'
description: 'Wazuh agent baglantisi koptu'
groups: '['local', 'wazuh_saglik']'
firedtimes: '1'
mail: 'True'
**Alert to be generated.
Olay artık 504 değil 100160 olarak, seviye 12’de düşüyor. mail: 'True' alarmın e-posta eşiğini geçtiğini söyler.
Logtest kuralın düşeceğini gösterir, gerçek bir kopmada düştüğünü göstermez. Fabrika ayarındaki 15 dakikayla tek bir deneme 18 dakika sürüyordu. Kuralın gerçek kopmada düştüğünü görmek için lab’da agents_disconnection_time ayarını geçici olarak 1 dakikaya kısalttım ve lnx02’yi yine duraklattım. 1 dakika canlıda kullanılacak bir değer değildir. Ayar ölçümden hemen sonra yedekten 15 dakikaya geri alındı. Son keepalive’dan 1 dakika 46 saniye sonra alerts.json’a şu kayıt düştü:
{"timestamp":"2026-11-14T03:43:42.707+0300","rule":{"level":12,"description":"Wazuh agent baglantisi koptu","id":"100160","firedtimes":1,"mail":true,"groups":["local","wazuh_saglik"]},"agent":{"id":"001","name":"lnx02","ip":"192.168.1.71"},"manager":{"name":"siem01"},"id":"1794617022.1255152","full_log":"ossec: Agent disconnected: 'lnx02-any'.","decoder":{"name":"ossec"},"location":"wazuh-monitord"}Olay satırı ve kaynağı 504’ünkiyle aynıdır, ama kayıt seviye 12’de ve "mail":true ile yazıldı. Aynı kopma için ayrıca bir 504 kaydı düşmedi: olay tek alarm olarak, 100160 adıyla geldi. 15 dakikalık ayarda olduğu gibi alarm burada da ayarlanan süreden sonra geldi.
Açıklamaya agent’ın adını $(agent.name) ile eklemek akla gelir. Lab’da denendi: gerçek alarmda da bu alan boş kaldı ve açıklama Wazuh agent baglantisi koptu: olarak yazıldı. Agent’ın adı kaydın agent alanında zaten durur ("name":"lnx02"), bu yüzden açıklama sabit bir metin olarak bırakıldı.
E-postanın gerçekten gitmesi için server’da e-posta bildiriminin açık olması gerekir. Lab’da email_notification no idi. Wazuh’un e-postayı bir relay sunucusu üzerinden göndermesini rehberin e-posta adımında anlattık.
Server Dururken Gelen Olaylar Kaybolur mu?
Server bakım için ya da bir arızada durabilir. Bu sırada agent’ların gördüğü olaylara ne olduğunu ölçmek için lab’da wazuh-manager servisini durdurdum. Sonra lnx02’de 2 saniye arayla 20 sahte SSH satırı ürettim. Satırlar logger ile yazıldı ve var olmayan bir kullanıcının giriş denemesini taklit etti:
date +%T; for i in $(seq 1 20); do logger -p auth.info -t sshd "Invalid user saglikdeneme$i from 192.168.1.250 port 4$i"; echo "$(date +%T) satir $i"; sleep 2; done; date +%TServer dururken dashboard açılmaya devam etti, ama ana sayfa kendiliğinden Server APIs ekranına yönlendi:
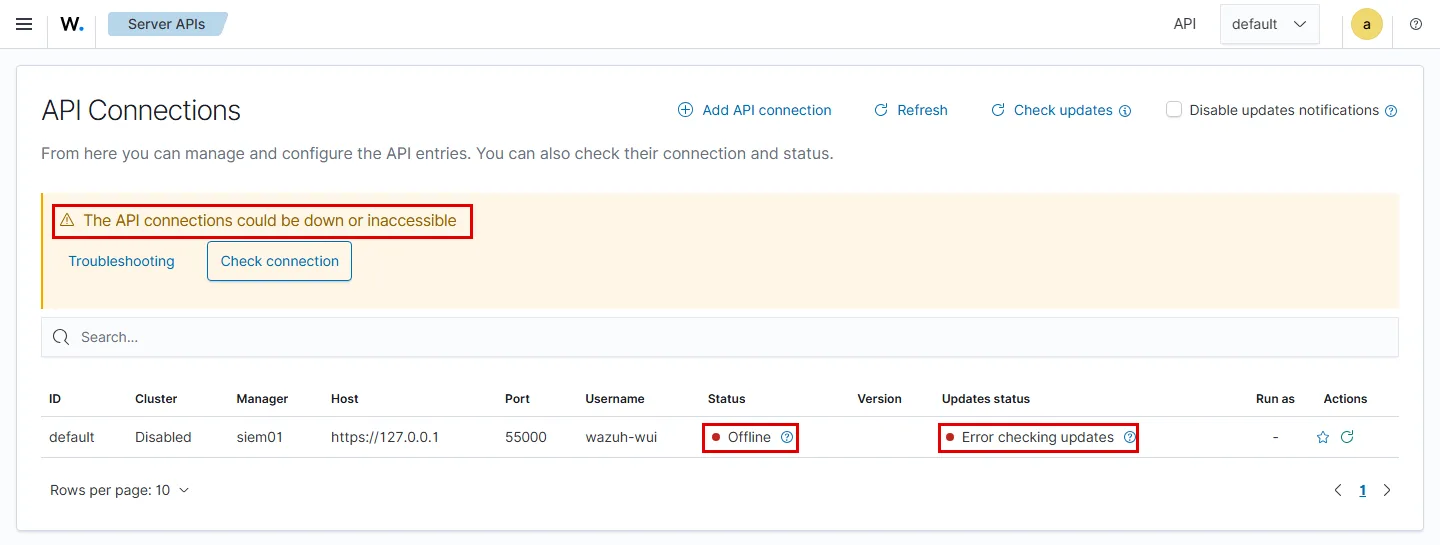
Agent tarafında bu sırada üç şey görüldü. wazuh-agentd her 10 saniyede bir server’a bağlanmayı denedi. Log okuyan süreç (wazuh-logcollector) Process locked due to agent is offline satırını yazıp bekledi. 20 satır yazıldıktan sonra agent’ın durum dosyasında tampon boştu:
sudo grep -E "msg_buffer|status|last_" /var/ossec/var/run/wazuh-agentd.state# Agent status:
status='disconnected'
last_keepalive='2026-11-14 00:45:48'
last_ack='2026-11-14 00:45:48'
msg_buffer='0'Server 3 dakika sonra yeniden başlatıldı. Agent 03:49:00’da bağlandı. İki saniye sonra alerts.json’da saglikdeneme geçen 20 kayıt vardı, yani 20 satırın 20’si de alarm oldu. Kayıtların hepsi 03:49:02’de yazıldı, olay satırları ise kendi saatlerini korudu (ilk satır Nov 14 00:45:52, lnx02’nin UTC saatiyle). 19 satır 5710 (seviye 5) olarak düştü. Sekizinci satır ise 5712 (seviye 10, SSH brute force) olarak düştü. Yani geç gelen olaylar da art arda gelen denemeleri sayan kurala girdi.
Bu denemede olayları agent’ın tamponu tutmadı, çünkü tampon boştu. Lab agent’ında tampon tanımlıydı (<client_buffer> bloğunda queue_size 5000 olay, events_per_second 500). Ama logcollector agent kopukken okumayı bekletti ve bağlantı dönünce satırların hepsi okundu. Ölçülen kesinti 3 dakikaydı. Daha uzun bir kesintide, log dosyası bu arada dönerse ne olduğu ölçülmedi.
Sağlık kontrolü açısından, server’ın durduğu dakikalarda alarm gelmemesi o dakikalarda olay olmadığı anlamına gelmez. Bu denemede alarmlar server dönünce toplu olarak ve aynı saniyede düştü.
Server Log’u ve Kuyruklar: ossec.log ve analysisd.state
Server’ın kendi log’u /var/ossec/logs/ossec.log’dur. Haftalık bakışta önce satır sayısı, sonra hangi modülden geldikleri okunur:
sudo grep -E "ERROR|CRITICAL|WARNING" /var/ossec/logs/ossec.log | awk "{print \$3, \$4}" | sort | uniq -c | sort -rn | head -20 266 indexer-connector: WARNING:
20 wazuh-modulesd:content-updater: WARNING:
4 wazuh-remoted: WARNING:
4 wazuh-authd: ERROR:
4 agent_control: ERROR:
1 sca: WARNING:
1 indexer-connector: ERROR:Lab log’u on günü kapsıyordu ve 291 uyarı, 9 hata taşıyordu. Sayı tek başına bir şey söylemez. 266 uyarı tek modülden, indexer’a veri yazan indexer-connector’dan geliyordu. Log’un son satırlarında bu uyarılar server’ın açılışından hemen sonraki saniyelere toplanmıştı: Failed to sync agent '001': No available server. Server, indexer henüz hazır değilken ona yazmaya çalışmıştı. Haftalık bakışta sorulacak soru şudur: aynı satır açılıştan sonra da tekrar ediyor mu?
Server’ın olay kuyruğunun dolup dolmadığı wazuh-analysisd.state dosyasındadır. Dosya birkaç saniyede bir yeniden yazılır. Bakılacak satır, atılan olay sayısıdır:
# Events received
events_received='2223'

# Events dropped
events_dropped='0'
events_dropped sıfırdan büyükse server gelen olayları işleyemiyor demektir ve atılan olay alarm üretmez. Aynı dosyadaki *_queue_usage satırları kuyrukların doluluk oranını verir. Lab’da hepsi 0.00’dı. Agent’lardan gelen bağlantının karşılığı wazuh-remoted.state dosyasındaki discarded_count satırıdır. Lab’da o da sıfırdı.
Agent tarafının log’u da kopmaları gösterir. lnx02’nin log’unda, server’ın her yeniden başlatılmasında şu satırlar vardı:
2026/11/13 23:33:35 wazuh-agentd: ERROR: (1137): Lost connection with manager. Setting lock.
2026/11/13 23:33:35 wazuh-agentd: ERROR: (1216): Unable to connect to '[192.168.1.47]:1514/tcp': 'Transport endpoint is not connected'.
2026/11/13 23:33:38 wazuh-logcollector: WARNING: Process locked due to agent is offline. Waiting for connection...
Son satır, agent bağlantısı yokken log okuyan sürecin beklemeye geçtiğini söyler. Bu beklemede olayların kaybolmadığı server’ı durdurduğumuz denemede ölçüldü.
Dashboard’un Sağlık Ekranları
Dashboard’da Wazuh’un kendi durumu iki ekrandadır.
Server management > Status server’ın süreçlerini renkli noktalarla, agent’ları da durumlarına göre sayıyla gösterir. Kırmızı nokta not running demektir. Lab’da altı nokta kırmızıydı, hepsi kullanılmayan özelliklerdi: wazuh-reportd de bu listede görünür. Aynı ekranda Restart manager düğmesi vardır.
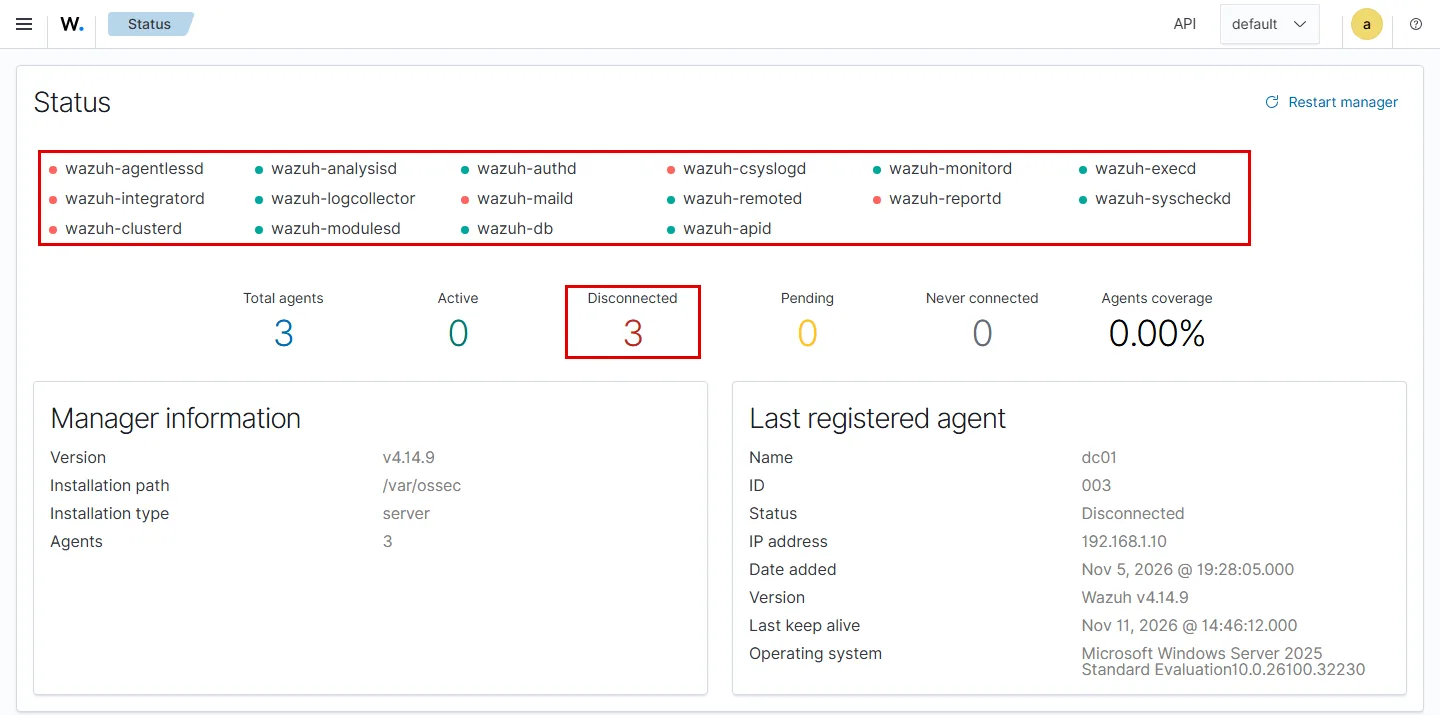
Dashboard management > Server APIs dashboard’un server’a bağlandığı API’yi gösterir. Lab’da Status Online’dı ve Updates status sütunu yeni bir sürüm olduğunu söylüyordu. Eski rehberlerin anlattığı ayrı bir health check sayfası ise lab’daki 4.14.9 dashboard’unda yoktu: /app/health-check adresi Application Not Found döndü.
Server management > Statistics server’ın aldığı olay ve bayt sayılarını grafikle gösterir. Bu grafikler wazuh-statistics indeksinden gelir.
Günlük ve Haftalık Wazuh Sağlık Listesi
Her gün, iki dakikalık bakış:
- Kopan agent:
agent_control -lnya da dashboard’daki Endpoints özeti. Dünden beri yeni bir Disconnected varsa nedeni sorulur. Bakım için kapatılan makine listede de kopuk görünür. - Küme rengi:
_cluster/healthçıktısındastatusgreenolmalı.yellowise hangi replikanın yerleşmediğine bakılır,redise o gün çözülür.
Her hafta:
- Servisler:
wazuh-control statusçıktısındawazuh-remoted,wazuh-analysisd,wazuh-db,wazuh-modulesdvewazuh-apidçalışıyor. - Filebeat:
filebeat test outputçıktısında her satırOK. - Disk:
df -hile disk %85’in altında. Büyüme haftadan haftaya not edilir, bir sonraki ayın doluluğu tahmin edilir. - Log:
ossec.log’da açılış dışında tekrar edenERRORveCRITICALsatırı yok. - Kuyruk:
wazuh-analysisd.statedosyasındaevents_droppedsıfır,wazuh-remoted.statedosyasındadiscarded_countsıfır.
Bir kez:
- Kopma alarmı: 504’ü seviye 12’ye taşıyan kural yazılır ve e-postanın gittiği bir kopmayla sınanır.
- Dışarıdan izleme: Wazuh server’ı tamamen durursa kendi alarmını da üretemez. Server’ın ayakta olduğunu başka bir sistemin izlemesi gerekir. Bu iş için kurumda çalışan bir izleme sistemi varsa Wazuh server’ı da ona eklenir.
Wazuh Sağlık Kontrolünde Sık Yapılan Hatalar
- Alarm yok diye her şey yolunda sanmak: Filebeat durursa ya da disk %95’i geçerse dashboard’a yeni alarm gelmez. Ekran sakin görünür.
- Kopma alarmını yalnız 504’e bağlamak: servisi düzgün durdurulan agent 504 üretmez, 506 üretir. Lab’da 17 dakika boyunca 504 gelmedi.
- Seviye 3 alarmın e-posta getireceğini sanmak: fabrika e-posta eşiği 12’dir. 504 de 506 da seviye 3’tür.
- Kopmayı hemen görmeyi beklemek: haber vermeden donan agent lab’da 18 dakika Active göründü.
not runningsatırlarını arıza sanmak:wazuh-mailde-posta kapalıyken,wazuh-clusterdtek sunucuda çalışmaz.- Yalnız indeks boyutuna bakmak: lab’da indeksler 19,3 MB, zafiyet veritabanı 13 GB tutuyordu. Disk eşiği bütün diske bakar.
- Log satır sayısından hüküm vermek: lab log’undaki 291 uyarının 266’sı tek modülün, indexer’a bağlanamayan
indexer-connector’ın uyarısıydı. - Wazuh’u yalnız Wazuh’la izlemek: server tamamen durunca kendi alarmını da üretemez.
Sonuç: Wazuh Kendini İzlemez, Onu Bir Liste İzler
Wazuh health check, Wazuh’un parçalarına sırayla bakmaktır: servisler, indexer kümesi, Filebeat, disk, log ve agent’lar. Lab’da servisi durdurulan agent iki saniye içinde kopuk göründü ve 506 üretti. Haber vermeden donan agent ise 18 dakika Active kaldı, sonra 504 üretti. İkisi de seviye 3’tü ve fabrika ayarında e-posta getirmiyordu. Diski dolduran indeksler değil, 13 GB’lık zafiyet veritabanıydı.
Girişteki benzetmeye dönersek: sayacını sökerken haber veren elektrikçi hemen kayda geçer, sessizce susan sayaç ise ancak süre dolunca fark edilir. Wazuh’ta haber veren kopma 506’dır, sessiz kopma 18 dakika sonra gelen 504. Kayıt dolabı dolarsa ya da telsiz bozulursa merkezin ekranı sakin görünür. Wazuh’ta kayıt dolabı disk, telsiz Filebeat’tir. Nöbeti devralan görevlinin merkezin kendisine bakması gibi, Wazuh’a da her gün iki, her hafta beş kalemle bakılır.
Rehberin sonraki ve son adımı, Wazuh’un yedeği ve sürüm yükseltmesidir: Wazuh güncellemesi yazımız.
Wazuh Sağlık Kontrolü Hakkında Sık Sorulan Sorular

BT Danışmanı | Ağ, Sistem ve Güvenlik Yönetimi
İlker Pehlivan, karmaşık BT altyapılarını ölçeklenebilir ve güvenli sistemlere dönüştürür. Buradaki rehberleri kendi laboratuvarında kurup ölçerek yazar.
LinkedInBenzer Makaleler

Wazuh Rehberi: Kurulumdan Alarma Adım Adım SIEM
Wazuh rehberi: kurulumdan agent'a, Windows log'undan e-posta alarmına on dört adımlık sıra. Her adım hangi kurumda gerekir, fabrika ayarı ne, lab'da ne ölçtük.

SIEM Hizmeti: Yönetilen Güvenlik İzleme ve Müdahale
SIEM hizmeti: domain controller, firewall, VPN ve sunucu logları tek yerde toplanır, kurallarla okunur, şüpheli olayda aynı ekip müdahale eder. Kapsam ve fiyat.

Wazuh Active Response: Otomatik Engelleme ve Muafiyet
Wazuh active response: SSH ve Windows brute force kaynağını firewall-drop ve netsh ile süreli engellemek, white_list ve kural seçimi, lab ölçümüyle.

Wazuh Upgrade: Yedek, Sıra ve Agent Yükseltmesi
Wazuh upgrade adım adım: yedeğin içini doğrulamak, indeks snapshot'ı, indexer, manager, Filebeat ve dashboard sırası, kesinti ve eski agent'lar, lab ölçümüyle.

Wazuh Active Directory İzleme: DC Olayından Alarma
Wazuh ile Active Directory izleme: domain controller'a agent, hazır Windows kurallarının seviyeleri, kilit zinciri, frekans eşiği ve özel kural, lab ölçümüyle.

Wazuh Agent Kurulumu: Windows'a GPO, Linux'a apt
Wazuh agent kurulumu: fabrikada parolasız gelen kaydı parolaya bağlamak, Windows'a GPO başlangıç betiğiyle toplu dağıtım, Linux'a apt ve lab ölçümleri.

Wazuh FIM: Dosya Bütünlüğü İzleme ve Kayıt Defteri
Wazuh FIM: fabrika ayarının neyi izlediği, realtime ve who-data, kayıt defterinin neden geç görüldüğü, report_changes, özel kural ve eBPF, lab ölçümüyle.

Wazuh Kurulumu: Ubuntu'da Tek Sunucu ve İlk Ayarlar
Wazuh 4.14 kurulumu tek sunucuda: asistanın iki uyarısı, parola dosyası, depo, bellek kilidi ve heap, tek shard, 90 günlük saklama ve ufw adım adım.

Wazuh Nedir? SIEM ve XDR Mimarisi, Portlar ve Donanım
Wazuh nedir, ne işe yarar? Açık kaynak SIEM ve XDR platformunun dört bileşeni, dışarı açılan portları, agentsız izleme ve donanım ihtiyacı, lab ölçümüyle.

Wazuh SCA: CIS Benchmark ile Yapılandırma Denetimi
Wazuh SCA: agent'ın CIS policy'sini seçmesi, puanın neyi ölçtüğü, kalan maddeyi GPO ile düzeltmek, yapılandırma kayması ve kuruma özel policy, lab ölçümüyle.

Wazuh Syslog ile FortiGate: Agentsız Log ve Alarm
Wazuh syslog ayarı: FortiGate logunu agentsız almak, allowed-ips, default ile rfc5424 farkı, UDP ile TCP, kilit eşiği ve özel kural, gerçek lab ölçümüyle.

Wazuh Vulnerability Detection: Envanterden CVE Alarmına
Wazuh vulnerability detection: kurulu yazılımın CVE ile eşlenmesi, feed erişimi, alarmın neden gelmediği, envanteri okumak ve önceliklendirme, lab ölçümüyle.

Baiting (Yemleme) Saldırısı Nedir? USB Bellek Tuzağı
Baiting nedir? Yerde bırakılan USB bellek, ücretsiz program ve hediye gibi yemlerle yapılan saldırı, klavye gibi davranan bellek ve şirkette alınacak önlemler.

BEC Nedir? İş E-postası Dolandırıcılığı ve Türleri
BEC (iş e-postası dolandırıcılığı) nedir, bağlantısız bir mail şirketten nasıl para çıkarır? Beş senaryo, gönderenin üç biçimi ve para gittiyse ilk saat.

Pharming Nedir? Doğru Adres, Sahte Site
Pharming nedir? Adres doğru yazılsa bile sahte siteye yönlendirme: hosts dosyası, modem ve DNS'in ele geçirilmesi, sertifika uyarısı ve şirketteki önlemler.

Pretexting Nedir? Bahaneyle Bilgi İsteyen Saldırgan
Pretexting nedir, bahane kuran saldırgan nasıl tanınır? Denetçi, yeni çalışan ve teknisyen kurguları, parça parça toplanan bilgi, quid pro quo ve doğrulama.

Quishing Nedir? QR Kod ile Oltalama Nasıl Anlaşılır
Quishing nedir, sahte QR kod nasıl anlaşılır? E-postadaki ve etiketteki QR kod kurguları, kodun neden filtreyi aştığı, okutmadan önce ve sonra yapılacaklar.

Smishing Nedir? Sahte SMS Nasıl Anlaşılır
Smishing nedir, sahte SMS nasıl anlaşılır? Kargo, banka ve kod isteyen kurgular, çalışanın telefonundan şirket hesabına açılan kapı ve tıklayınca yapılacaklar.

Spear Phishing (Hedefli Oltalama) Nedir? Örnekleri
Spear phishing (hedefli oltalama) nedir, toplu oltalamadan farkı ne? Bilginin nereden toplandığı, şirkete gelen örnek kurgular ve korunma yolu.

Spoofing Nedir? E-posta, Numara, IP ve DNS Taklidi
Spoofing nedir, phishing'den farkı ne? E-posta, arayan numara, SMS, IP, ARP ve DNS spoofing türleri, neden mümkün oldukları ve şirkette alınacak önlemler.

Tailgating Nedir? Kapıdan Arkanızdan Giren Saldırgan
Tailgating nedir, piggybacking ile farkı ne? Kartlı kapıdan arkadan girilmesi, içeri giren saldırganın yapabildikleri, kartlı geçişin sınırı ve önlemler.

Typosquatting Nedir? Benzer Alan Adı ve Punycode
Typosquatting nedir? Bir harfi değişmiş alan adı, farklı uzantı, alt alan adı hilesi, Punycode ve homograf, DMARC'ın neden durdurmadığı ve korunma yolları.

Vishing Nedir? Telefonla Oltalama Nasıl Anlaşılır
Vishing nedir, telefonla oltalama nasıl anlaşılır? BT destek, banka ve yönetici kılığında gelen aramalar, arayan numaranın taklidi ve geri arama kuralı.

Whaling Nedir? Yöneticiyi Hedefleyen Oltalama
Whaling nedir, spear phishing ve CEO fraud'dan farkı ne? Yöneticinin neden hedef olduğu, ona gelen kurgular ve yönetici hesabını koruyan önlemler.

Phishing (Oltalama) Nedir? Türleri ve Nasıl Anlaşılır
Phishing (oltalama) nedir, sahte mail ne ister ve nasıl anlaşılır? Türleri, beş işaret, MFA varken çalınan oturum ve tıkladıysanız ilk saatte yapılacaklar.

Sosyal Mühendislik Nedir? Saldırı Türleri ve Örnekleri
Sosyal mühendislik nedir, saldırgan bir çalışanı hangi kaldıraçlarla ikna eder? Phishing, BEC, telefon ve fiziksel türler, örnekleri ve üç savunma katmanı.

Görüntülü Görüşmede Deepfake Video: Sahte Patron, Sahte Aday
Görüntülü görüşmede deepfake video ile sahte yönetici ve sahte aday: Hong Kong vakası, uzaktan mülakat, liveness testi ve toplantının dışında doğrulama.

Ödeme Talimatı Doğrulama: CEO Fraud'u Durduran Kurallar
Ödeme talimatı doğrulama: CEO fraud'a karşı geri arama, IBAN değişikliği, çift onay, kod kelime ve istisna yolu. Tek sayfalık örnek kural metniyle birlikte.

Ses Klonlama Nedir? Yapay Zeka Ses Taklidiyle Dolandırıcılık
Ses klonlama nedir, yapay zeka ses taklidi kaç saniyelik kayıtla yapılır? Kendi sesimin klonu, telefon bandında dinleme ve şirketi koruyan doğrulama kuralları.

Deepfake Nedir? Sahte Ses ve Görüntü Şirketi Nasıl Hedefler?
Deepfake nedir, sahte ses ve görüntü nasıl çalışır, şirkete hangi üç yoldan gelir? Gerçek vakalar, birkaç saniyelik kayıt ve asıl korumanın neden kural olduğu.

SIEM Nedir? Log Korelasyonu, Alarm ve SOC Farkı
SIEM nedir, log toplamaktan farkı ne? Normalleştirme, korelasyon kuralı ve alarm, lab'da ölçülmüş örnekle. SOC, EDR ve XDR farkı ve kurulumdan önceki sıra.

CISO Nedir? Bilgi Güvenliği Yöneticisi Ne Yapar?
CISO nedir: kurumun bilgi güvenliğinden sorumlu üst yönetici. Görevleri, CIO ile farkı, kime bağlanacağı ve CISO'su olmayan bir KOBİ'de bu işi kim yapar.

DHCP Snooping Nedir? Sahte DHCP Sunucusunu Durdurmak
DHCP snooping nedir? Switch'in yalnız güvenilen porttan gelen DHCP cevabını geçirmesi. Lab'da sahte sunucunun dört teklifi de düştü, logda portu kaldı.

ACL Nedir? Dosyadan Buluta Erişim Kontrol Listesi
ACL nedir: dosya izninden switch'e, firewall'dan buluta aynı mantıkla çalışan erişim kontrol listesi. Kural sırası, örtük ret ve sık hatalar, lab ölçümleriyle.

2FA Nedir? İki Faktörlü Doğrulama ve Yöntem Seçimi
2FA nedir, iki faktörlü kimlik doğrulama nasıl çalışır ve hangi yöntem gerçekten koruyor? SMS'ten donanım anahtarına beş yöntemi ve kurulum sırasını anlattık.

Brute Force Nedir? Deneme Sınırı ve Hesap Kilitleme
Brute force saldırısı nedir, password spraying'den farkı ne? Hesap kilitleme nasıl kurulur, kilit kaçıncı denemede devreye giriyor? Laboratuvarda ölçtük.

Siber Güvenlik Farkındalık Eğitimi: Sınav ve Sertifika
Siber güvenlik farkındalık eğitimi: kurumunuza özel, en az 45 dakikalık uzaktan oturum, sınırsız katılım, sonunda sınav ve sertifika. Oltalama, parola, KVKK.

Siber Güvenlik Önlemleri: Şirketler İçin Katmanlı Rehber
Siber güvenlik önlemleri nelerdir? Kimlik, ağ, uç nokta, veri, izleme ve yama katmanlarında şirketlerin alması gereken tedbirler ve öncelik sırası.

Zafiyet Taraması Hizmeti: Düzenli Tarama ve Rapor
Zafiyet taraması hizmeti: dış yüzey, iç ağ ve web taraması, önceliklendirilmiş rapor, bulguların kapatılması ve tekrar tarama. Tek seferlik ya da düzenli.

DLP Çözümü: Veri Sızıntısı Önleme Kurulumu ve Yönetimi
DLP çözümü: veri sınıflandırma, ürün seçimi, izle-uyar-engelle ile kademeli policy kurulumu, istisna yordamı ve uyarıları inceleyen yönetim hizmeti.

Kurumsal Antivirüs ve EDR: Seçim, Kurulum ve Yönetim
Kurumsal antivirüs ve EDR: ürün seçimi, merkezi konsol kurulumu, eski üründen geçiş ve uyarıları okuyan yönetilen izleme; lisans teklifte ayrı kalemdir.

Antivirüs ve EDR Farkı Nedir? Kurumda Hangisi Gerekir
Antivirüs imzayla tanır, EDR davranışa bakar. İkisinin farkı, hangi kurumda hangisinin yettiği ve sahada asıl arızayı çıkaran yönetim hataları burada.

DLP (Veri Kaybı Önleme) Nedir? Sınırları ve Kurulumu
DLP verinin kurumdan çıktığı noktaları denetler. Nasıl çalıştığı, neyi durduramadığı, policy'nin nasıl yayılacağı ve bu işi kimin yöneteceği burada.

ISO 27001 Danışmanlığı: BT Tarafında Hazırlık ve Gap Analizi
ISO 27001 danışmanlığı: gap analizi, Ek A teknik kontrollerinin BT karşılığı ve denetimde istenen kanıt düzeni. Belgeyi kuruluş verir, hazırlığı biz yaparız.

Sızma Testi (Pentest) Hizmeti: Kapsam, Süreç ve Rapor
Zafiyet taraması bir liste verir, sızma testi o listenin hangisinin gerçekten sömürülebildiğini kanıtlar. Kapsamı birlikte çıkarıyor, bulguyu rapora bağlıyoruz.

Şifreleme Nedir? Simetrik, Asimetrik ve Hash Farkı
Şifreleme nedir, kaç türü vardır? Gizlilik, bütünlük ve kimlik üç ayrı iştir. Simetrik, asimetrik ve hash fonksiyonlarının farkı ve kurumsal karşılığı.

Certificate Authority Nedir? İç CA ile Public CA Farkı
Sertifika otoritesi (CA) nedir, güven zinciri nasıl kurulur? Kurumsal ağda iç CA ile public CA farkını, self-signed sertifikanın ne zaman yettiğini anlatıyoruz.

ISO 27001 Belgesi Nasıl Alınır? Şartların Tam Listesi
ISO 27001 belgesi nasıl alınır? Şartların tam listesi (Madde 4-10 ve Ek A'nın 93 kontrolü), denetim aşamaları ve teknik kontrollerin BT tarafındaki karşılığı.

5651 Log Yönetimi ve İnternet Loglama Çözümü
5651 kapsamında merkezi log toplama, zaman damgası ve değiştirilemez arşiv kuruyoruz. Firewall markanızdan bağımsız çalışır; donanım değiştirmeden uyum sağlanır.

Siber Güvenlik Sıkılaştırma (Hardening) Hizmetleri
Siber güvenlik sıkılaştırma ile sunucu, ağ cihazı ve uç nokta güvenlik açıklarınızı CIS Benchmark ve NIST standartlarına göre uçtan uca kapatıyoruz.
Ücretsiz Değerlendirme
Sessizce kopan bir Wazuh agent'ı lab'da 18 dakika Active göründü. Sizin kurulumunuza birlikte bakalım mı?
İçindekiler
Ana Hizmet
Siber Güvenlik